Классическая история: три года бэкапы снимаются, места занимают прилично, а в день аварии выясняется, что последний архив битый с прошлой весны. Никто не заметил, потому что никто не восстанавливал.
Правило, к которому я пришёл: каждый бэкап должен быть восстановлен автоматически, до того как его сочтут успешным.
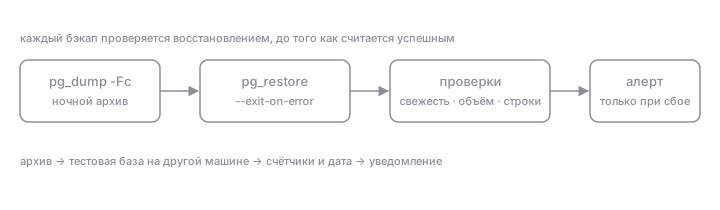
Схема
- Ночью снимается
pg_basebackupили логическая копия. - Сразу после — восстановление в отдельный каталог на той же машине (или на дешёвой резервной).
- Запуск PostgreSQL на нестандартном порту, три запроса на проверку.
- Если любой шаг упал — алерт, а не тишина.
#!/bin/bash
set -euo pipefail

DUMP=/var/backups/pg/latest.dump
pg_dump -Fc -Z6 -d app -f "$DUMP.new"
mv "$DUMP.new" "$DUMP"

TESTDB=verify_$(date +%s)
createdb "$TESTDB"
pg_restore -d "$TESTDB" --no-owner --exit-on-error "$DUMP"

COUNT=$(psql -tA -d "$TESTDB" -c "select count(*) from users")
if [ "$COUNT" -lt 1000 ]; then
  echo "verify failed: users=$COUNT" >&2
  exit 1
fi
dropdb "$TESTDB"
--exit-on-error в pg_restore — ключевой флаг. Без него битый дамп восстанавливается «частично», с кучей сообщений об ошибках и кодом возврата 0. Именно так бэкапы и умирают незаметно.
Что проверять, кроме «команда не упала»
- Свежесть. Дата внутри дампа должна быть вчерашней. Файл, который не обновлялся неделю, обычно означает, что упал таймер.
- Объём. Резкое падение размера на 90% — почти всегда признак того, что дамп снялся с пустой базы.
- Наличие данных в ключевых таблицах. Порог
≥ 1000 строкловит случай «восстановили схему без данных».
Отдельная боль: права
Восстанавливать надо тем же пользователем, который будет читать базу после аварии, иначе половина грантов потеряется. Мы держим pg_dumpall --globals-only отдельным файлом и восстанавливаем его первым — это две строки, которые экономят час ручной работы в самый неподходящий момент.
И последнее: проверка должна идти на другой машине. Восстановление на том же диске, который утром отвалится, проверяет только вашу веру в SAN.